Deadline gRPC в цепочке сбора измерений
Запрос диспетчера проходит через шлюз, агрегатор и архив. Каждый компонент получает одинаковый полный тайм-аут, поэтому нижний обработчик продолжает работу после того, как пользователь уже увидел отказ. Для предсказуемого поведения нужно рассматривать время ожидания как контракт всей операции и понимать, как оставшийся бюджет передаётся между реальными RPC. Это особенно важно при переменной задержке полевого канала.
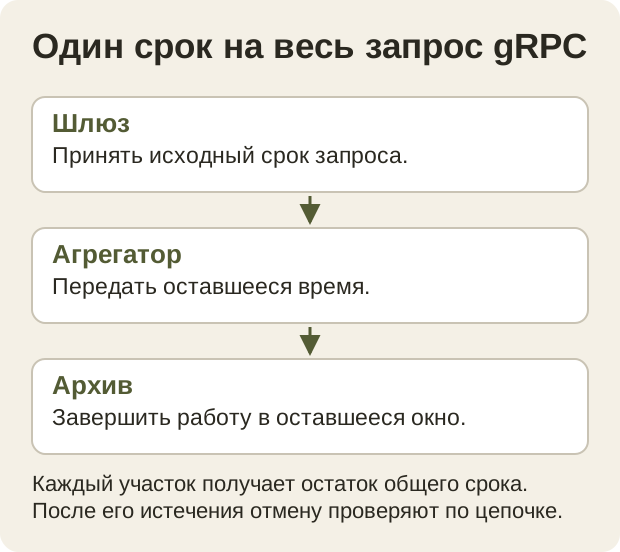
Определить общую границу ожидания
Документация gRPC описывает deadline и его распространение; поддержка автоматической передачи зависит от языка и реализации. Поэтому нельзя предполагать одинаковое поведение всех клиентов. Ведомость интеграции должна показывать, где устанавливается ограничение, кто передаёт остаток и как нижний обработчик замечает отмену. (gRPC — Deadlines)
Сначала описывают ожидаемый результат: чтение текущего состояния, получение архива или другая безопасная операция. Затем фиксируют допустимую длительность по требованиям владельца, не назначая универсального числа для любого хозяйства. Сетевой тайм-аут, deadline RPC и прикладной срок актуальности данных сохраняют разными параметрами. Они отвечают на разные вопросы и могут требовать разных действий.
Испытать задержку на одном звене
На стенде создают учебный запрос и предусмотренно задерживают только один обработчик. По корреляционному идентификатору наблюдают начало, оставшееся время и завершение каждого звена. В логах сохраняют исходные отметки, а elapsed-сравнения выполняют согласованным способом. Разница местных отображений часов не должна превращаться в новый бюджет ожидания на каждом переходе.
После истечения срока проверяют клиентский статус и реакцию сервера на отмену. Отмена ожидания не должна автоматически трактоваться как доказательство отсутствия любого прикладного эффекта. Для операций записи требуется собственная модель результата и повторов. Здесь испытание проводят на безопасной учебной выборке, чтобы не менять состояние исполнительных механизмов во время исследования времени.
Проверить восстановление после отказа
Следующий обычный запрос должен проходить без накопления забытых работ. Если нижняя операция не может быть немедленно остановлена, это ограничение явно отражают в проекте и наблюдаемости. Повтор запроса согласуют с его семантикой, а не запускают бесконечно по любому DEADLINE_EXCEEDED. Ресурсные последствия проверяют на предусмотренной стендовой нагрузке.
Приёмочный акт содержит схему передачи бюджета, версии библиотек и наблюдения задержанного сценария. Работа завершена, когда общая граница ожидания реализована предсказуемо и каждый компонент объяснимо реагирует на её окончание. Тогда оператор видит понятный отказ, а служба сопровождения может установить, какой участок исчерпал время, вместо поиска случайной «медленной сети» по всему маршруту телеметрии.

